


 Spanish (pdf)
 Article in xml format
 Article references

 Automatic translation
 Send this article by e-mail
 Cited by SciELO
 Similars in
SciELO

 Permalink

Introducción
Las sociedades actuales están caracterizadas por la presencia de datos de diversa índole en todos los ámbitos de la vida, especialmente a partir del uso de diferentes dispositivos tales como celulares, relojes inteligentes y computadoras. Lo anterior no implica que los datos no hayan existido antes, sino que la cantidad y la intensidad han incrementado en los actuales contextos digitales. Además, los datos se han convertido en un activo económico muy relevante; incluso se les ha llamado el “
” (Servando, 2020). Es importante tener en cuenta que estos también poseen implicaciones éticas significativas, como las relacionadas con la privacidad, el control político, la libertad y el consentimiento.1nuevo oro
Asimismo, cabe señalar que ha surgido, para describir a las sociedades actuales, el concepto de dataísmo que, acuñado hace una década, hace alusión al papel central de los datos para entender la realidad, en sentido filosófico, en todos sus ámbitos (Brooks, 2013). Por otra parte, según Drayson y Bashir (s.f), en una obra titulada The Evolution of Data Management, a nivel histórico se pueden identificar diferentes etapas o eras de la gestión de datos, siendo la actual the digitally orchestrated age, la cual se caracteriza por la completa digitalización de las actividades empresariales, la automatización, el machine learning y el papel de la inteligencia de negocio como eje central.
En otras palabras: vivimos en una época atravesada por los datos. Sin embargo, es fundamental tener en cuenta que un dato, entendido como una representación o construcción simbólica de una variable determinada, por sí mismo, no dice nada. Incluso, después de su procesamiento, los datos deben ser dotados de sentido. Es un error creer que, por ejemplo, son como el conjunto de símbolos verdes que se deslizan frente a Neo en Matrix2 , los cuales explicaban, por sí mismos, una supuesta realidad objetiva3. T.S Elliot, poeta estadounidense, señalaba este error, de una manera más amplía, en su poema titulado El primer coro de la roca4:
5”. Es decir, el conocimiento o la comprensión de un fenómeno requiere de algo más que hechos aislados, proposiciones individuales o, en este caso, datos. Es importante que se enmarquen en contextos, narrativas, intereses y discursos específicos, por lo que es fundamental tener en cuenta ciertos sesgos, paradojas y falacias que, al realizar la contextualización y dotación de sentido, llevan a que los datos no se apeguen a ciertas realidades y que no sean adecuados para la toma de decisiones.“¿Dónde está la sabiduría que hemos perdido en conocimiento? / ¿Dónde el 5que hemos perdido en información?
Teniendo en cuenta lo anterior, el propósito de este artículo es ofrecer una reflexión y sistematización de los principales sesgos, paradojas y falacias que afectan el proceso de comprensión, análisis y visualización de un conjunto específico de datos y sus asociaciones. Es crucial destacar que el análisis se centra en cómo se utilizan los datos para tomar decisiones, no necesariamente en los procesos de automatización algorítmica. Para ello, se realiza inicialmente un acercamiento a los conceptos de análisis y visualización de datos en el contexto de las capas de una arquitectura de Big data, así como a los de sesgo, paradoja y falacia. Luego, se detallan los aspectos más relevantes dentro de las capas previamente definidas; finalmente, se presentan las reflexiones conclusivas.
Apuntes metodológicos
En el nivel metodológico, el artículo adopta un enfoque documental y bibliográfico, el cual, según García y Pérez (2022), implica la recuperación, el análisis y la interpretación crítica de información que ha sido recopilada y analizada previamente por otros investigadores. A la luz de esto, la pregunta que guía esta investigación es: ¿cuáles son las principales falacias, sesgos y paradojas que afectan los procesos de visualización y análisis de datos en las arquitecturas de Big data? Para responder a esta pregunta, se realizó una revisión de artículos científicos y académicos, ejemplos en blogs y periódicos, casos de estudio, así como manuales y libros relevantes en el campo de la analítica de datos. Durante la presentación de los resultados, se citan los documentos y ejemplos consultados en cada caso.
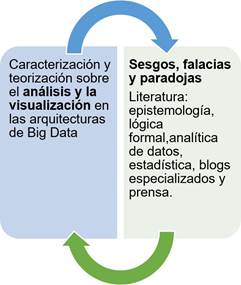
En cuanto al tipo de investigación, es relevante destacar que es cualitativa, centrada en el aspecto conceptual, es decir, en los significados (Barrantes, 2016) y cómo estos se interrelacionan. Específicamente, consiste en identificar, a partir de la caracterización teórica de las capas de visualización y análisis, las falacias, sesgos y paradojas sistematizadas en diversas fuentes literarias6 sobre estadística, analítica de datos, epistemología y lógica formal, como también en ejemplos comunes en blogs especializados y prensa que pueden estar presentes en estos procesos de Big data. Este proceso se muestra en la figura 1.
En cuanto al proceso de selección de los textos y fuentes, es fundamental considerar que, al abordar sesgos, falacias y paradojas, conceptos ampliamente estudiados en la filosofía, se realizó una revisión de enciclopedias como la Stanford Encyclopedia of Philosophy y la Routledge Encyclopedia of Philosophy, así como de elaboraciones nacionales de instituciones públicas, específicamente en materiales de la materia de Filosofía del MEP.
El objetivo fue identificar qué tipos de errores lógicos, tal y como se conceptualizan teóricamente más adelante, pueden manifestarse en las arquitecturas de Big data. Esta revisión se complementó con la consulta de literatura sobre errores estadísticos, con base en las categorías de sesgo, paradoja y falacia. Además, se amplió la investigación a textos de otras disciplinas, como medicina y física, para determinar si estos errores podrían presentarse de manera similar en los procesos de analítica de datos. Mediante la diversidad de referencias estudiadas se planteó una comprensión más completa de la posible presencia y efectos de estos errores en el modelo de arquitectura propuesto.
Cabe señalar que lo anterior se profundizó a partir de artículos especializados en ciencias sociales y filosofía, con el fin de brindar una aproximación actual y crítica en torno a los sesgos, paradojas y falacias estudiadas. Además, se revisaron documentos y guías de actores importantes en el sector, como por ejemplo la guía práctica de NTT7, los aportes de DataHeroes8 y la conceptualización en torno a las arquitecturas propuesta por IBM y por Solano y Leiva9 (2014)9. Asimismo, se tomaron en cuenta sistematizaciones de experiencias y estudios de caso tanto en artículos académicos como en notas periodísticas.
De igual forma, se estudiaron blogs populares, tales como el de Litera10, Geckoboard11, VisualCapitalist12 y Connectif13, los cuales tienen entradas referentes a data fallacies. Cabe señalar que, al ser blogs, suelen simplificar la información, como por ejemplo no tomar en cuenta la distinción entre falacias, sesgos y paradojas14, ni tampoco discutir los problemas filosóficos y de fundamentación epistemológica15. Es importante destacar que las publicaciones académicas con respecto a estos errores lógicos en Big data son escasas, por lo que se recurrió a estos blogs como fuente de información, ya que sistematizan las experiencias de empresas y usuarios.
El proceso de selección de los errores lógicos, estuvo determinado por la construcción teórica en torno a la definición de sesgo, falacia y paradoja, es decir, el análisis consistió en la identificación de la coherencia conceptual entre los errores lógicos generales y las definiciones teóricas problematizadas. En otras palabras, se analizó qué errores se ajustaban a las definiciones brindadas en el marco teórico de la investigación.
Respecto a los alcances y limitaciones, es importante tener en cuenta que la propuesta es meramente bibliográfica y conceptual, por lo que no profundiza en otros aspectos que pueden estar presentes en las dinámicas en las que se enmarcan los errores lógicos: cultura organizacional, consideraciones sociológicas, tecnociencia, teoría del poder, etc. Además de lo anterior, la investigación plantea un registro inicial de estos errores, sin embargo, no es un inventario final, ya que el artículo se plantea como una propuesta que pueda ser ampliada y discutida por trabajos futuros.
Consideraciones teóricas
Se presentan acá los conceptos relacionados a diferentes posturas teóricas que fundamentan la investigación. Así, se profundiza, especialmente, en el concepto de Big data y sus arquitecturas, como también en los sesgos, las falacias y las paradojas. Entonces, a nivel metodológico, se tiene en cuenta lo expuesto en el apartado anterior, es decir, el marco teórico que permite comparar los conceptos de visualización y análisis con los diferentes errores identificados, es decir, los relaciona y, por tanto, los justifica.
Análisis y visualización de datos en big data
El Big data como concepto de análisis es reciente, debido a que fue utilizado por primera vez en la década de los noventa. De esta forma, cabe señalar que, a pesar de ser un concepto ubicuo, no existe un consenso claro en torno a la manera en la que se acuño el término: John Mashey en Silicon Valley, el artículo de Michael Cox y David Ellsworth de la NASA en 1998, Weiss e Indurkhya en el ámbito de la computación en 1998 o las reformulaciones en el ámbito de la genética (Diebold, 2012; Tapia, 2022). Ahora, para el presente artículo no se problematiza este aspecto, puesto que el interés no es su historia, sino, más bien, su contenido conceptual. Además de que se debe tener en cuenta que el Big data aparece en un contexto determinado y a partir de algunos antecedentes e hitos relevantes a nivel histórico: la memoria virtual de Fritz-Rudolf Güntsch, la ley bibliométrica del aumento exponencial de Derek Price, la ley de Parkinson de Tjomsland, como también la automatización (Sánchez, 2019).
De manera similar, si bien no existe una definición totalmente compartida de lo que es Big data (Camargo- Vega, Camargo-Ortega y Joyanes-Aguilar, 2014), se puede entender como un conjunto de activos de información de gran variedad, alta velocidad y volumen, que requiere formas innovadoras, en el marco de los avances tecnológicos del siglo XXI, de procesamiento y análisis, es decir, no con base en los métodos tradicionales. Cabe señalar que el fin del Big data, dentro de los procesos de gestión pública y privada, es el procesamiento de información capaz de propiciar un conocimiento basado en la identificación y comprensión de asociaciones y patrones relevantes para la toma de decisiones, así como para la automatización de procesos (Hernández-Leal, Duque-Méndez y Moreno-Cadavid, 2017). En el caso de la presente investigación, se enfatiza en el primer aspecto, es decir, no necesariamente en la automatización. Dentro de la literatura del Big data se suele asumir la existencia de una serie de adjetivos conocidos como las V: Variedad, Veracidad, Valor, Volumen y Velocidad (Márquez, 2020). Estos adjetivos describen las características ideales que debería tener un conjunto de datos categorizado como Big data.
Además, en gestión de datos se suele hablar de arquitecturas, mismas que son la estructura de los diferentes sistemas de gestión de datos empresariales, es decir, la forma en que se organizan los componentes y la manera en la que interactúan entre sí. Acá cabe señalar que están modeladas por los servicios que ofrecen las empresas que controlan el sector: IBM, Microsoft, Oracle y Cloudera (Leiva y Solano, 2014). Así, pues, se debe considerar, para entender una arquitectura de datos, el concepto del ciclo de vida de la data. En general, se suele asumir, tal y como señalan El Arass y El Souissi (2018), que existen cinco fases generales: adquisición, almacenamiento, procesamiento, uso y eliminación. Cabe señalar que tienen relación con las capas lógicas, las cuales, según Mysore, Shrikant y Jain (2014), son obtención, tratamiento, análisis y visualización. Ahora bien, las capas lógicas se refieren al diseño o abstracción, mientras que, por otra parte, la arquitectura es más concreta y se refiere a la materialización de ese diseño. En otras palabras, las capas lógicas son los elementos abstractos generales que le brindan coherencia al modelo teórico y a la materialización de la arquitectura.
Respecto a esto, a nivel nacional, en uno de los pocos artículos académicos elaborados en torno a arquitectura de datos, en este caso Big data Analytics: propuesta de una arquitectura (Solano y Leiva, 2014), las personas autoras plantean cuatro capas: origen de datos, recuperación y transformación, análisis y visualización. Para el presente trabajo, se enfatizó solo en las capas de análisis y visualización, es decir, la primera, entendida como el proceso orientado a identificar, mediante herramientas matemáticas, econométricas y estadísticas, las tendencias, asociaciones, patrones y, en general, información útil para la toma de decisiones; la visualización, por su parte, se refiere a la forma en la que se sistematiza y presenta la información (Valero, 2014). Esta última se encuentra ligada al Storytelling, que es la práctica de generar, a partir de los datos, un relato coherente (Nussbaumer, 2015). Es, en muchas ocasiones, a la hora de desarrollar la narrativa y el contexto discursivo de sentido, en la que se comenten la mayor cantidad de falacias, sesgos y paradojas.
Sesgos, paradojas y falacias comunes en análisis y visualización de datos
Al trabajar con datos, se debe entender que estos no son entes puros, es decir, son recolectados, interpretados, analizados y presentados por personas, en el caso de Big data, con ayuda de inteligencia artificial, por lo que pueden verse afectados por sesgos y falacias. Además, puede haber intereses políticos, dado que en muchos casos los nuevos datos generan resistencias, es decir, contradicen narrativas o creencias instauradas. En la literatura de analítica de datos, esto se suele ilustrar mediante el efecto Semmelweis, entendido como la acción de rechazar evidencia que contradice normas, paradigmas y creencias preestablecidas.16 (Gupta, Saini, Oberoi, Kalra y Nasir, 2020).
Con respecto a las arquitecturas de Big data, especialmente en la etapa de visualización de los datos, en el ámbito organizacional, institucional o empresarial, estos sesgos pueden llevar a que las decisiones y sus acciones respectivas no tengan los efectos deseados o que, incluso, tengan consecuencias contrarias a lo planteado en las estrategias e instrumentos de planificación. Esto se conoce como el efecto cobra, entendido como el desarrollo de acciones que conllevan el efecto opuesto al esperado, agravando en muchas ocasiones el problema que se intenta solucionar. Su nombre proviene del libro Der kobra effekt, escrito por el economista Horst Siebert en 2001. Hace alusión a la decisión tomada por el gobierno de la India, ante la presencia de muchas cobras en la ciudad, de pagar por cada cobra muerta, lo que llevó a que las personas las reprodujeran en sus casas para matarlas y recibir la recompensa, provocando, al final, una mayor cantidad de cobras en la ciudad. (Ventura, 2020).
Volviendo a Semmelweis, a nivel empresarial y de management, especialmente en startups, existe un error común debido a una creencia compartida: un DAU/MAU de aproximadamente 45 %, es decir, similar al de Facebook en sus inicios, indica éxito. Sin embargo, más allá de las creencias generales en torno a esta métrica, se encuentran una serie de hechos y evidencias que se suelen ignorar porque contradicen la idea de que el DAU/MAU es un indicador concluyente por sí mismo: muchas de las personas usuarias no usan el núcleo de la aplicación, es decir, sus características centrales; así como que el DAU/MAU no describe el uso que se le da a la aplicación. Razonar de manera errónea, en este caso, sería asumir que, en una lectura superficial a partir del DAU/MAU, la startup es exitosa. Una situación similar se suele presentar con los KPI o indicadores claves de calidad, esto cuando se enfatiza en uno o dos sin tomar en cuenta otros o cuando no se los analiza en conjunto. Es una simplificación de los problemas, lo que se expone más adelante al hablar del efecto McNamara.
En cuanto a uno de los errores estudiados en este artículo, en este caso las falacias, estas se refieren a diversos tipos de argumentos formalmente erróneos e incorrectos, pero que, en muchas ocasiones, suelen ser, en sentido psicológico, convincentes. A nivel cognitivo, pueden aceptarse de manera intuitiva, es decir, parecen razonables dentro de determinados marcos de sentido o narrativas; sin embargo, a nivel estructural, el paso de las premisas a la conclusión es equivocado. Es debido a lo anterior que su identificación es de gran importancia, ya que, como se expone más adelante, en muchas ocasiones se realizan de forma adrede, pero, en otras, de forma inconsciente o intuitiva, ya que, por ejemplo, con respecto a la falacia ad hominem, muchas personas la emplean dentro de sus procesos argumentativos sin darse cuenta.
Un sesgo se refiere, en términos generales, a un defecto de interpretación en el que se asigna un valor desigual a favor o en contra de, en este caso, unas determinadas conclusiones obtenidas a partir de un dataset o un conjunto de datos específico. Cabe señalar que las conclusiones se utilizan como argumentos a favor o en contra de ciertas posibles decisiones o acciones, por lo que los sesgos, en muchos casos, son sistemáticos, es decir, no aleatorios o azarosos (Manterola y Otzen, 2015).
Ahora bien, una paradoja es una proposición, teoría o idea que resulta ilógica, incoherente o contradictoria. En este caso, como se expone más adelante al describir la Paradoja de Simpson, son proposiciones o conclusiones que, en apariencia, resultan contradictorias al sentido común o a un grupo de creencias preestablecidas. Asimismo, estas han sido muy populares para ilustrar ideas o teorías en ciencia y filosofía: la paradoja del abuelo, influyente en las reflexiones en torno a los viajes en el tiempo; la paradoja de Epiménides, muy relevante en la matemática del siglo XX; el gato de Schrödinger en el campo de la cuántica o la paradoja de los gemelos utilizada por Einstein para reflexionar sobre la teoría de la relatividad especial. En este caso, más que la paradoja en sí, en analítica lo que se estudia es la respuesta que se le suele dar.
Seguidamente una vez definidas las falacias, los sesgos y las paradojas, se caracterizan algunas de las más comunes y relevantes en el ámbito del análisis y visualización de datos en el contexto de las capas de análisis y visualización en las arquitecturas de Big data . Es decir, como se explicó, se describen los errores que se comenten al intentar dotar de sentido a los datos.
Resultados
En este punto se exponen, a partir de la revisión documental y bibliográfica, los principales errores, para este efecto, sesgos, paradojas y falacias, identificados para las fases de análisis y visualización, teniendo en cuenta las definiciones brindadas con anterioridad.
Cherry Picking
Es un sesgo muy similar al dragado de datos o data dredging, que consiste en seleccionar, de un conjunto amplio, solo los datos que refuerzan y consolidan la narrativa elegida, es decir, la que es funcional para ciertos intereses. En el ámbito de la analítica de datos, por ejemplo, con un mismo dataset, dos personas pueden llegar a conclusiones diferentes. En este caso, si se realiza de forma adrede, además de un error lógico o epistemológico, se puede considerar como un problema ético.
Cabe señalar que es una acción y un error muy común, en algunos casos, en el desarrollo general de la ciencia. Por ejemplo, recientemente se dio una discusión, en el ámbito de la filosofía y la epistemología, en torno al realismo científico17, puesto que Kyle Stanford y Peter Vickers realizaron una crítica en la que, de acuerdo a Mizrahi (2015), donde solament se tomaron en cuenta las proposiciones que estaban en consonancia con la tesis a defender y no las evidencias en contra.
Overfitting o sobreajuste
En términos generales, se refiere a un sesgo en el que se asume que un modelo estadístico y matemático debe corresponderse casi totalmente con su conjunto de entrenamiento o con su dataset. Este es un problema asociado al machine learning, pues, si, por ejemplo, el modelo estadístico se corresponde totalmente, el modelo falla al incorporar nueva información y realizar generalizaciones. Las principales soluciones son algorítmicas: early stopping, referida a la detención del entrenamiento de los datos antes de la aparición de ruidos18; incorporación de más datos en el modelo; así como “network-reduction”, que consiste es una disminución de la data (Xing, 2019).
Asimismo, se considera un error debido a que las personas analistas y encargadas de la visualización en la arquitectura de capas lógicas señalada en el presente artículo cometen el error de razonamiento de asumir que los resultados de un modelo que se adapta casi completamente a su dataset de entrenamiento se adecuan a la realidad, cuando, como se expuso en el párrafo anterior, implica lo contrario. Es un sesgo común, debido a que es intuitivo asumir que a mayor porcentaje de correspondencia existe mayor capacidad de aprendizaje en un proceso de machine learning.
El sesgo del superviviente
El sesgo del superviviente es un error de razonamiento en el contexto de la argumentación lógica, presente en la analítica de datos, que implica poner la atención únicamente en una serie de elementos que han superado una determinada selección, ignorando todos aquellos que no lo superaron. Este sesgo puede implicar que la persona que observa llegue a ignorar la existencia de todos esos elementos, los cuales, en muchas ocasiones, pueden contar con características significativas y relevantes (Elston, 2021).
En la historia existen dos eventos que, a pesar de las dudas en torno a su historicidad, resultan paradigmáticos (Felton, 2021): en la Primera Guerra Mundial, los generales estadounidenses se alarmaron porque llegaban muchos soldados con heridas en la cabeza, específicamente los que utilizaban el casco Brodie, modelo diseñado en acero en 1915, por lo que asumieron que los cascos no eran efectivos. Sin embargo, el caso era el contrario: los soldados sobrevivían y recibían solo una herida gracias a los Brodie. El otro caso, el de la Segunda Guerra Mundial, se refiere a los aviones de combate estadounidenses, los cuales volvían a la base militar con agujeros de bala en el fuselaje, las alas exteriores y la cola, por lo que reforzaron estas áreas. Sin embargo, la única información que recibían, tal y como señaló el matemático Abraham Wald, era de los sobrevivientes. Es decir, realmente las áreas que habían recibido las balas eran las más fuertes, por lo que no necesitaban ser reforzadas.
En el ámbito de la analítica es bastante común en los análisis financieros. Por ejemplo, cuando se estudia el desempeño de grupos de inversiones, usualmente fondos mutuos con diferentes personas, sociedades y empresas, se realiza tomando en cuenta solo a los sobrevivientes, excluyendo a los fondos y empresas que
ya no aportan o, incluso, existen, debido a sus rendimientos deficientes. Lo anterior implica que el estudio conlleva un sesgo, proporcionando una visión muy optimista sobre el rendimiento que no necesariamente se corresponde con la realidad.
Efecto Hawthorne
Elton Mayo, autor australiano y considerado como uno de los teóricos más relevantes de la historia del management (Martino, 2023), realizó una serie de experimentos en Hawthorne Works, una fábrica eléctrica en Chicago, para estudiar la influencia de los diferentes tipos de iluminación en la productividad. Los estudios señalaron que la productividad disminuyó tras el estudio, es decir, cuando las personas que trabajaban en la fábrica ya no estaban siendo observadas (Sujatha, Mayurnath y Pathak, 2019). Por tanto, el efecto Hawthorne se entiende como el comportamiento de las personas que son parte de un experimento y que muestran una modificación en algún aspecto de su conducta por el hecho de saber que están siendo estudiadas y observadas. Si bien existen algunas críticas o reformulaciones en torno a la existencia de este efecto (Witton y Elbourne, 2014), se puede asumir, siguiendo a Sedwick y Greenwood (2015), que existe algún tipo de influencia en el comportamiento de las personas que participan en un estudio.
En el caso del Big data, es fundamental que la persona analista tenga en cuenta este sesgo y, por tanto, una conciencia clara de dónde vienen sus datos y la manera en la que fueron recolectados, incluso si son producto de procesos de automatización. Esto tiene que ver con lo señalado previamente con respecto a las V del *Big data*, específicamente en torno a los adjetivos de valor y veracidad.
Error de McNamara
El sesgo del Error de McNamara se refiere a la tendencia a enfocarse en métricas y datos cuantitativos bajo una supuesta pretensión de objetividad, sin considerar otros factores cualitativos (Singh y Shah, 2023). Se suele priorizar los datos más sencillos de cuantificar, similar a la Navaja de Ockham, eligiendo el dato más simple ante un conjunto de opciones. Su nombre proviene de la práctica de McNamara durante la guerra de Vietnam, donde la principal métrica era el recuento de bajas enemigas, ignorando variables cruciales.
Esta falacia también fue notable durante la gestión inicial de la pandemia de SARS-CoV-2, donde se basaron decisiones en métricas fácilmente medibles como pruebas positivas y hospitalizaciones. En la visualización y análisis de datos, es crucial reconocer la falacia de McNamara para evitar conclusiones simplistas que pueden llevar al fracaso de estrategias en diversos ámbitos, un error vinculado al efecto cobra mencionado teóricamente.
Paradoja de Simpson
En términos generales, se entiende como una paradoja en la que una tendencia determinada que aparece en diferentes conjuntos de datos, desaparece cuando estos conjuntos son combinados y, usualmente, en su lugar surge la tendencia opuesta. Por otra parte, el fenómeno se presenta, también, cuando una relación estadística entre dos variables en una población desaparece al ser dividida en subpoblaciones (Stanford Encyclopedia of Philosophy, 2021) o, en términos más simples, cuando la relación entre dos variables se modifica cuando se tiene en cuenta el posible efecto de otra variable no contemplada hasta el momento. Es muy utilizada en epidemiología. Un ejemplo muy claro es el de comparar la efectividad de dos hospitales tomando en cuenta el número de personas fallecidas y considerar, por tanto, que el que tiene menores muertes es el más eficaz; sin embargo, al introducir variables relacionadas al tipo de patologías que se abordan en cada hospital, la conclusión puede cambiar (Molinero, 2001). En el caso costarricense, algunas reacciones a noticias relacionadas a la vacunación en torno al SARS-CoV-2 pudieron haber cometido, de manera intuitiva, el error de no tomar en cuenta los supuestos de la Paradoja de Simpson, sobre todo como respuesta a los titulares.19 Por ejemplo, aDiarioCR.com publicó una nota, el 31 de enero del 2022, titulada
El 70% de los hospitalizados por Covid-19 están vacunados, ante lo que, en los comentarios20, algunas personas empezaron a cuestionar la efectividad de las vacunas, esto a pesar de que en la nota se clarificaba que existían otros elementos a tomar en cuenta. Aspectos relacionados21 a la Paradoja de Simpson, en este caso, consisten en asumir una relación entre personas vacunadas y hospitalizaciones ignorando variables que podrían modificar las conclusiones: factores de riesgo, número de vacunas, etc.
A propósito, en este artículo, se expuso de manera muy general la paradoja de Simpson para tener una visión general del problema a la hora de trabajar con datos en el ámbito de arquitecturas de Big data. Sin embargo, su correcto análisis implica la cuantificación estadística de las relaciones entre las variables, así como un riguroso estudio de las relaciones causales en un fenómeno específico.
Falacia del jugador
La falacia del jugador, o falacia de Montecarlo, consiste en la idea de que un evento aleatorio en el pasado condiciona los hechos aleatorios en el presente. Por ejemplo, uno de los errores comunes es el de asumir que un suceso aleatorio tiene más probabilidad de ocurrir porque no ha sucedido durante un periodo de tiempo extenso. Esto se suele observar en la lotería, ya que muchas personas consideran que, si un número lleva mucho tiempo sin salir, probablemente salga. De hecho, el año anterior, El Financiero publicó una nota (Cerdas, 16 de diciembre de 2023) en la que indicaba, para el público en general, los números que nunca han salido premiados, esto para que fueran tenidos en cuenta, ya que el año anterior, en 2022, salió el 00 por primera vez.
En análisis y visualización de datos es una falacia muy común, pues, por ejemplo, se suele cometer el error de asumir que, debido a condiciones contextuales y azarosas que ocurrieron en el pasado, una tendencia a la baja en ciertos índices de rendimiento va a ser revertida porque, al igual que los números de la lotería que saldrían por llevar algún tiempo sin salir, es el momento de una tendencia a la alta. Esto implica pasividad organizacional y que no se tomen decisiones para revertir la situación.
Falacia de las manos calientes
Similar a la falacia anterior, ambas se suelen estudiar de forma conjunta (Stöckl, Huber, Kirchler y Lindner, 2015). Como su nombre lo dice, hace alusión al básquetbol, específicamente al momento en el que un jugador se encuentra en una racha de canastas. Un ejemplo reciente es el caso de Stephen Curry, jugador de la NBA y de los Golden State Warriors, quien tuvo, hasta el 18 de diciembre del 2023, una racha de 268 partidos anotando triples. Cuando se encontraba en la racha, se asumía como un hecho que iba a anotar al menos un triple durante el juego.
A nivel empresarial, se suele considerar la misma actitud: cuando hay rachas positivas a nivel de rendimiento, sustentadas por los datos, se asume que la situación va a ser la misma en el futuro. Al igual que en la falacia del jugador, esto lleva a la pasividad o a la asunción de riesgos innecesarios. La persona analista de datos debe ser consciente de esto al llevar a cabo sus investigaciones y posteriores visualizaciones.
Falacia de la falsa causalidad o causa falsa
Es una falacia muy común en todos los ámbitos, no solo en analítica, que consiste en la atribución de una causa a un evento a pesar de que no exista evidencia. En analítica, el error se presenta al confundir correlación con causalidad. A estos errores se les llama relaciones espurias y las personas que gestionan, analizan y visualizan datos las deben tener en cuenta.
Los ejemplos de este tipo de correlaciones utilizando datasets abundan: la tasa de divorcio en Maine y su correlación con el consumo de margarina; el número de personas que se ahogan en las piscinas y su relación con la cantidad de películas de Nicolas Cage; o la correlación estadística entre gastos en ciencia, espacio y tecnología y los suicidios por estrangulamiento (Vigen, s.f.).22
Conclusiones
Las sociedades contemporáneas se caracterizan por la integración de los datos en todas las esferas de la vida, lo cual se debe en parte a su valor como recurso político y económico significativo. Sin embargo, los datos en sí mismos no ofrecen información hasta que se les interpreta mediante análisis y visualización. Durante estos procesos es común cometer varios errores, como sesgos y falacias, incluidas tres falacias y una paradoja específicas, así como siete sesgos, destacando el efecto cobra y el efecto Semmelweis, que se analizaron en el marco teórico.
Por tanto, es fundamental destacar que los errores identificados no son meramente lógicos, sino que también presentan dimensiones éticas, ejemplificadas por el fenómeno del Cherry Picking. Adicionalmente, se observó que algunas falacias y la Paradoja de Simpson demandan un enfoque más profundo en estadística y lógica formal. Asimismo, otras falacias ampliamente reconocidas, como la apelación a la emoción, la generalización apresurada y la falacia ad hominem, no se abordaron en este análisis, focalizado en la dinámica de los datos.
Asimismo, en este trabajo se buscó llegar a aquellos profesionales dedicados al análisis y la visualización de datos dentro de estructuras de Big data; sin embargo, las falacias, sesgos y paradojas discutidas son extensibles a otros ámbitos y disciplinas, especialmente en las Ciencias Sociales.
Par terminar, este artículo propone explorar líneas de investigación sobre el rol de la ética en la interpretación de sesgos, falacias y paradojas, así como sobre la legitimidad epistemológica del Big data, enfocándose en su carácter científico derivado de los procesos analíticos y de visualización. Además, el análisis conceptual, documental y bibliográfico llevado a cabo en esta investigación podría ampliarse mediante estudios de caso, encuestas y entrevistas en el ámbito privado y público para entender mejor la prevalencia de estos errores en distintas organizaciones y desarrollar estrategias efectivas para mitigar su incidencia.

