<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>0001-6002</journal-id>
<journal-title><![CDATA[Acta Médica Costarricense]]></journal-title>
<abbrev-journal-title><![CDATA[Acta méd. costarric]]></abbrev-journal-title>
<issn>0001-6002</issn>
<publisher>
<publisher-name><![CDATA[Colegio de Médicos y Cirujanos de Costa Rica]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S0001-60022007000200003</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[¿Hay diferencias significativas entre tratamientos?: Primera parte]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Camacho-Sandoval]]></surname>
<given-names><![CDATA[Jorge]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,UNA  ]]></institution>
<addr-line><![CDATA[ ]]></addr-line>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>04</month>
<year>2007</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>04</month>
<year>2007</year>
</pub-date>
<volume>49</volume>
<numero>2</numero>
<fpage>81</fpage>
<lpage>82</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://www.scielo.sa.cr/scielo.php?script=sci_arttext&amp;pid=S0001-60022007000200003&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.sa.cr/scielo.php?script=sci_abstract&amp;pid=S0001-60022007000200003&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.sa.cr/scielo.php?script=sci_pdf&amp;pid=S0001-60022007000200003&amp;lng=en&amp;nrm=iso"></self-uri></article-meta>
</front><body><![CDATA[  <b><font face="Arial">     <p align="center">¿Hay diferencias significativas entre tratamientos? Primera parte</p> </font><font face="Arial" size="2"> </font></b>     <p><font face="Arial" size="2">Jorge Camacho-Sandoval</font></p>     <p><font face="Arial" size="2">Los investigadores en ciencias de la salud se hacen preguntas como: ¿Se deben las diferencias entre muestras al efecto de los tratamientos?, ¿se deben las diferencias al criterio de clasificación de los grupos, por ejemplo al sexo, grupo edad o etnia?, o simplemente, ¿se deben las diferencias a que las muestras están compuestas por individuos distintos?, dicho de otra manera, ¿se deben las diferencias al azar o son estadísticamente significativas?</font></p>     <p><font face="Arial" size="2">Como se mencionó en la nota estadística anterior<a href="#1"><sup>1</sup></a> cuando se estudian muestras lo más frecuente es encontrar diferencias entre éstas, aunque hayan recibido el mismo tratamiento. Eso ocurre debido a que los individuos que componen cada muestra son diferentes, al menos parcialmente.</font></p>     <p><font face="Arial" size="2">El problema básico es entonces, determinar si las diferencias observadas entre muestras son debidas al azar o, por el contrario, se pueden atribuir a los tratamientos o criterios de clasificación. Dos de las herramientas que la estadística ofrece para resolver ese problema son la estimación por intervalos y las pruebas de hipótesis.<a href="#2"><sup>2</sup></a></font></p>     <p><font face="Arial" size="2">El caso más simple sería cuando se quiere comparar un grupo o muestra con un valor de referencia. Veamos un ejemplo: Se evalúa el consumo energético en una muestra de 11 mujeres, se obtuvo un consumo promedio de 6753.6 Kjulios y una desviación estándar de 1142.1 Kjulios. Se desea determinar si el consumo energético en la población de mujeres de donde procede la muestra difiere del consumo recomendado por la OMS, que es de 7725 Kjulios.</font></p>     <p><font face="Arial" size="2">Una posibilidad es realizar una prueba de hipótesis, que consta de 4 elementos, a saber: la hipótesis nula (H<sub>0</sub>),la hipótesis alternativa (H<sub>1</sub>), un estadístico de prueba y la regla de decisión.</font></p>     <p><font face="Arial" size="2">La H<sub>0</sub> es,en general, que no existe diferencia significativa, es decir, que la diferencia observada se debe al azar. La H<sub>1</sub> es lo contrario, es decir, supone que la diferencia observada es significativa. No se hace referencia ni a la dirección ni a la magnitud de la diferencia, lo que indica que haremos una prueba de dos colas, es decir, se supone que la diferencia puede ser positiva o negativa. En general, esta es la mejor forma de hacer la prueba.</font></p>     <p><font face="Arial" size="2">El estadístico de prueba tiene que tener dos características básicas, primero, debe ser obtenido a partir de los datos de la muestra y segundo se debe conocer su distribución de probabilidad. En el caso de promedios, diferencias entre promedios, proporciones y diferencias entre proporciones, si la variable se distribuye normalmente o si el tamaño de muestra es 30 ó superior, los estimadores siguen la distribución normal, la famosa campana de Gauss. Con muestras pequeñas, esos indicadores siguen otra distribución, la de t de Student. Como la distribución de t se aproxima a la distribución normal al crecer el tamaño de muestra, se puede usar, para los casos mencionados, la distribución de t; la forma general de un estadístico de prueba s: </font></p>     ]]></body>
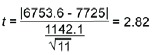
<body><![CDATA[<p style="text-align: center;"><font face="Arial" size="2">Estadístico prueba= <u>Valor observado del estimador - Valor del estimado según H<sub>0</sub></u>    <br> &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp;&nbsp; &nbsp;&nbsp; Error estándar del estimador</font></p>     <p><font face="Arial" size="2">El criterio de decisión es probabilístico. Si la probabilidad del estadístico de prueba es pequeña, suponiendo que la H<sub>0</sub> es cierta, menor que un valor arbitrario establecido previamente por el investigador, entonces se rechaza la H<sub>0</sub> y se acepta como válida la H<sub>1</sub>.</font></p>     <p><font face="Arial" size="2">En el caso del ejemplo mencionado, los componentes de la prueba de hipótesis son:</font></p>     <p><font face="Arial" size="2">H<sub>0</sub>: La diferencia poblacional entre el valor del estimador (6753.6 Kjulios) y el valor recomendado por la OMS (7725 Kjulios) no es significativa, se debe al azar.</font></p>     <p><font face="Arial" size="2">H<sub>1</sub>: La diferencia poblacional entre el valor del estimador (6753.6 Kjulios) y el valor recomendado por la OMS (7725 Kjulios) es significativa.</font></p>     <p><font face="Arial" size="2">Estadístico de prueba: <b>    <br> &nbsp;&nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; &nbsp;&nbsp; <img src="/img/fbpe/amc/v49n2/formula1.JPG" title=""  alt="" style="width: 152px; height: 55px;"></b></font></p>     
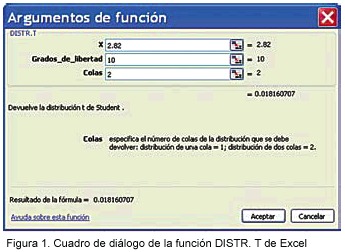
<p><font face="Arial" size="2">Regla de decisión: Si la probabilidad de t es inferior al 5% (0.05), rechazo la H<sub>0</sub>; en los demás casos, no se rechaza H<sub>0</sub>. ¿Cómo obtener la probabilidad del estadístico de prueba? Se puede utilizar la función DISTR.T de la hoja de cálculo Excel, introduciendo la siguiente información en el cuadro de diálogo correspondiente (<a href="#f1">Figura 1</a>):</font></p>     <p><font face="Arial" size="2">X: valor del estadístico, en este caso, 2.82</font></p>     ]]></body>
<body><![CDATA[<p><font face="Arial" size="2">Grados de libertad: tamaño de muestra – 1 =11 – 1 =10</font></p>     <p><font face="Arial" size="2">Colas: 2</font></p> <a name="f1"></a>     <div style="text-align: center;"><img src="/img/fbpe/amc/v49n2/3451i1.JPG" title=""  alt="" style="width: 345px; height: 252px;"></div>     
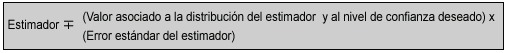
<p><font face="Arial" size="2">La probabilidad del estadístico de prueba es 0.01816, es decir, inferior a 0.05, por lo que aplicando la regla de decisión, se rechaza H<sub>0</sub> y se acepta H<sub>1</sub> como válida y se concluye que, <b>a nivel de la población</b>, la diferencia entre el consumo energético de mujeres y el consumo recomendado por la OMS es significativa.</font></p>     <p><font face="Arial" size="2">Una forma alternativa de abordar el problema es estimar un intervalo de confianza para el promedio, esto es, un rango de valores dentro del cual se supone, con un nivel de confianza o probabilidad predeterminado, que se encuentra el <b>promedio de la población </b>de la cual procede la muestra. Si el valor de referencia se encuentra dentro de ese intervalo, se concluye que la diferencia entre el promedio poblacional y el valor de referencia se debe al azar. Si por el contrario, el valor de referencia no se encuentra dentro del intervalo de confianza, se concluye que la diferencia entre ambos valores es significativa.</font></p>     <p><font face="Arial" size="2">La estructura general de un intervalo de confianza es la siguiente:</font></p>     <div style="text-align: center;"><img src="/img/fbpe/amc/v49n2/formula2.JPG" title=""  alt="" style="width: 507px; height: 53px;"></div>     
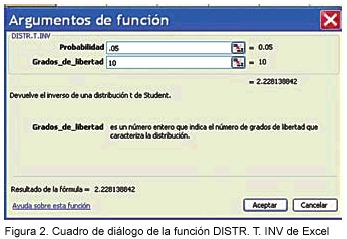
<p><font face="Arial" size="2">En el ejemplo mencionado se tiene un tamaño de muestra n =11, por lo tanto, se debe usar la distribución de t. Para ello es preciso buscar el valor correspondiente a 10 grados de libertad, es decir, n -1, y un nivel de confianza determinado. Ese valor se obtiene usando la función DISTR.T.INV de Excel; la información se introduce en la caja de diálogo (<a href="#f2">Figura 2</a>), como sigue:</font></p>     <p><font face="Arial" size="2">Probabilidad: 1 –Nivel de confianza deseado, por ejemplo, 1 -0.95 =0.05</font></p>     <p><font face="Arial" size="2">Grados de libertad: tamaño de muestra – 1 =11 – 1 =10</font></p>     ]]></body>
<body><![CDATA[<p><font face="Arial" size="2">El valor resultante es: 2.228</font></p> <a name="f2"></a>     <div style="text-align: center;"><img src="/img/fbpe/amc/v49n2/3451i2.JPG" title=""  alt="" style="width: 347px; height: 239px;"></div>     
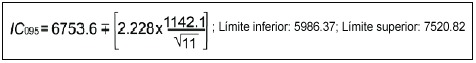
<p><font face="Arial" size="2">En el ejemplo, el intervalo de confianza para el estimado del promedio poblacional será:</font></p>     <div style="text-align: center;"><img src="/img/fbpe/amc/v49n2/formula3.JPG" title=""  alt="" style="width: 476px; height: 63px;"></div>     
<p><font face="Arial" size="2">Es decir, el promedio poblacional se encuentra, con un 95% de confianza, entre 5986.37 y 7520.82 Kjulios. Como el intervalo no contiene el valor recomendado por la OMS de 7725 Kjulios, se concluye que el consumo promedio de las mujeres en la población es significativamente menor al recomendado por la OMS. En la próxima nota, se extenderán estas técnicas a la comparación de dos grupos.</font></p> <font face="Arial" size="2"><b>     <p>Referencias </p> </b> </font>     <!-- ref --><p><font face="Arial" size="2"><a name="1"></a>1. Camacho J. Investigación, poblaciones y muestra. Act Med Costarric, 49:11-12. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=029981&pid=S0001-6002200700020000300001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Arial" size="2"><a name="2"></a>2. Zar, J. H. Biostastical análisis. 4th ed. New Jersey: Prentice Hall, 1999.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=029982&pid=S0001-6002200700020000300002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><p><font face="Arial" size="2">Profesor, Maestría en Epidemiología, Posgrado en Ciencias Veterinarias, UNA.</font></p> <font face="Arial" size="2"><b>     <p>Correspondencia: </p> </b></font>     ]]></body>
<body><![CDATA[<p><font face="Arial" size="2">Correo lectrónico: <a  href="mailto:jcamacho@ice.co.cr">jcamacho@ice.co.cr</a></font></p>      ]]></body><back>
<ref-list>
<ref id="B1">
<nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Camacho]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Investigación, poblaciones y muestra]]></article-title>
<source><![CDATA[Act Med Costarric]]></source>
<year></year>
<volume>49</volume>
<page-range>11-12</page-range></nlm-citation>
</ref>
<ref id="B2">
<nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Zar]]></surname>
<given-names><![CDATA[J. H]]></given-names>
</name>
</person-group>
<source><![CDATA[Biostastical análisis]]></source>
<year>1999</year>
<edition>4</edition>
<publisher-loc><![CDATA[^eNew Jersey New Jersey]]></publisher-loc>
<publisher-name><![CDATA[Prentice Hall]]></publisher-name>
</nlm-citation>
</ref>
</ref-list>
</back>
</article>